#УликиИнфры
Приложение периодически отвечает с задержкой. Время выполнения запросов растёт, появляются тайм-ауты, а пропускная способность TCP-соединений снижается.
На Linux-сервере обнаруживаем увеличение счётчика:
TcpRetransSegs
Первая гипотеза очевидна: в сети теряются пакеты, поэтому TCP вынужден отправлять их повторно.
Это возможное объяснение. Но далеко не единственное.
Разберём, что действительно означает этот показатель, как найти источник проблемы и какие действия могут её устранить.
1. ДИАГНОСТИЧЕСКИЙ СИГНАЛ
TCP обеспечивает надёжную доставку потока данных. Если отправитель определяет, что ранее переданные данные необходимо отправить повторно, он выполняет retransmission.
В Linux для наблюдения можно использовать:
nstat -az TcpRetransSegsTcpRetransSegs — системный счётчик повторно переданных TCP-сегментов.
Важны две особенности.
Во-первых, это накопительный показатель.
Большое абсолютное значение ничего не говорит о текущем состоянии сети без информации о времени наблюдения и объёме трафика.
Нужно измерять прирост за определённый интервал.
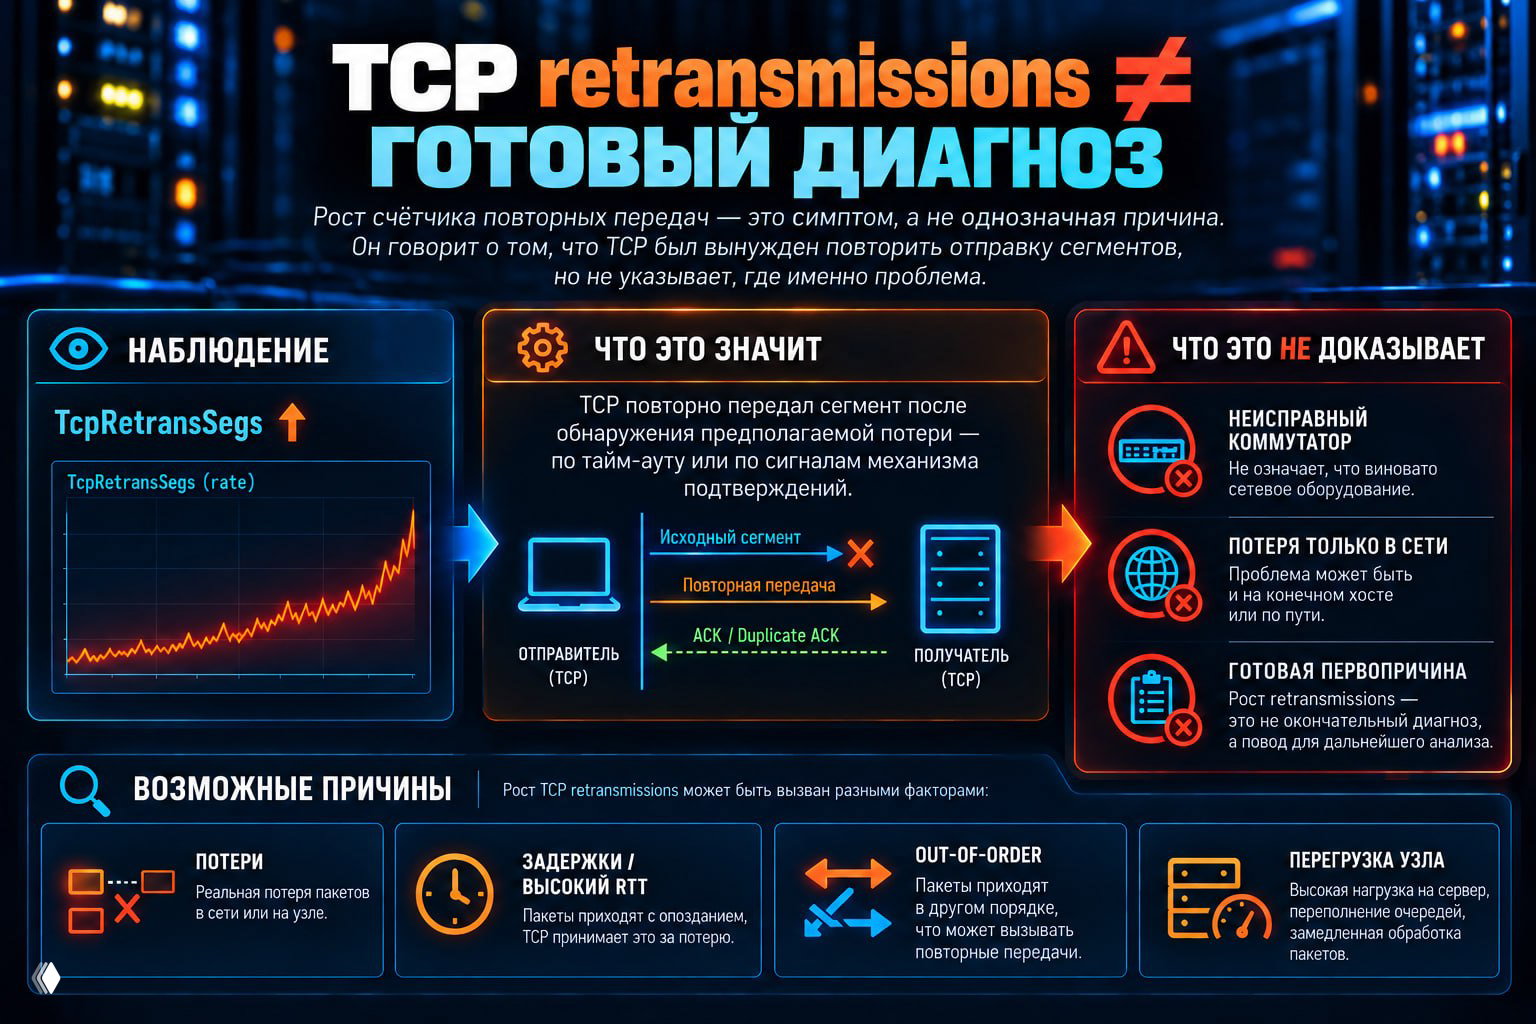
Во-вторых, retransmission не равен подтверждённой потере пакета в сети.
Повторная передача может происходить из-за потери данных, отсутствия своевременного ACK, переупорядочивания сегментов или ошибочного определения потери.
Следовательно:
TCP retransmission ≠ network packet loss
И тем более:
TCP retransmission ≠ неисправный коммутатор
2. РЕАЛЬНЫЕ ПРИЧИНЫ
Рассмотрим основные сценарии.
Гипотеза 1. Фактическая потеря пакетов
Сегменты могут теряться из-за:
— ошибок физических интерфейсов; — неисправных кабелей или трансиверов; — переполнения очередей передачи; — перегрузки сетевых устройств; — ограничений и отбрасывания трафика на промежуточном оборудовании.
TCP обнаруживает отсутствие ожидаемого подтверждения и инициирует восстановление передачи.
Гипотеза 2. Высокая задержка и нестабильный RTT
При перегрузке маршрута задержка доставки может существенно увеличиваться.
Если подтверждение не поступило до истечения RTO (Retransmission Timeout), TCP может повторно отправить данные, хотя исходный сегмент фактически не был потерян.
Здесь важно исследовать динамику RTT, а не только retransmissions.
Гипотеза 3. Переупорядочивание пакетов
Переупорядочивание TCP-сегментов может возникать при балансировке по отдельным пакетам, изменении маршрутов, переключении путей или особенностях распределения трафика в сетевом оборудовании.
Современные реализации TCP учитывают такое поведение, но при определённых обстоятельствах оно всё же может приводить к лишним повторным передачам.
Гипотеза 4. Проблема находится на конечном узле
Даже если физическая сеть исправна, проблемы могут возникать из-за перегрузки сетевого стека, недостатка ресурсов обработки пакетов или потерь в очередях самого Linux-сервера.
Поэтому локализовать неисправность исключительно по счётчикам коммутатора нельзя.
3. ПРАКТИЧЕСКИЕ ПРОВЕРКИ
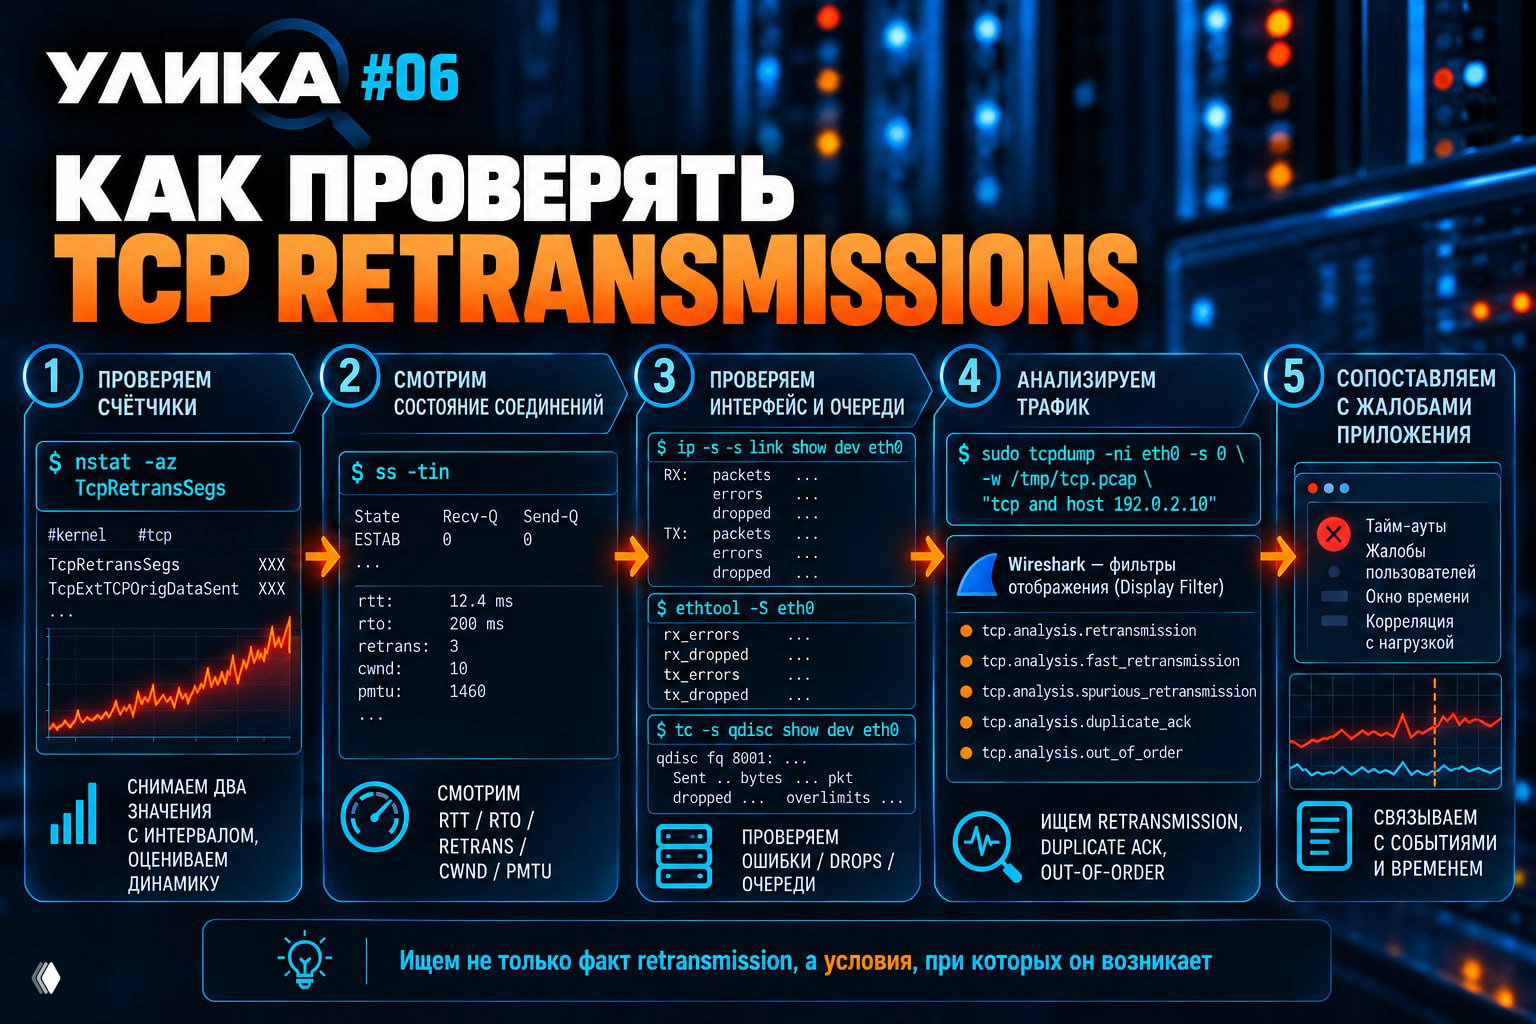
Шаг 1. Измеряем динамику
Снимаем значения дважды с интервалом, например, 60 секунд:
nstat -az TcpRetransSegsСопоставляем прирост счётчика с объёмом TCP-трафика и периодами ухудшения работы приложения.
Для дополнительного контекста, если счётчик поддерживается ядром, полезен:
nstat -az TcpExtTCPOrigDataSentОн показывает количество исходных TCP-сегментов с данными без повторных передач.
Это позволяет оценивать масштаб retransmissions относительно передаваемого трафика, а не только их абсолютное количество. Такая оценка не является прямым измерением процента потерь в сети.
Шаг 2. Проверяем конкретные соединения
ss -tinЗдесь нас интересуют:
- •
rtt— оценка времени прохождения туда и обратно; - •
rto— текущий тайм-аут повторной передачи; - •
retrans— информация о повторных передачах; - •
cwnd— окно перегрузки TCP; - •
pmtu— известный TCP путь MTU.
Если проблема наблюдается только у соединений с определённым адресом, круг поиска заметно сужается.
Если задержки и retransmissions возникают одновременно у разных соединений, нужно исследовать общие компоненты их путей.
Шаг 3. Проверяем сетевой интерфейс
ip -s -s link show dev ens192И статистику драйвера:
ethtool -S ens192Обращаем внимание на ошибки приёма и передачи, отбрасывание пакетов, переполнения и специфичные для сетевого адаптера показатели.
Конкретные названия счётчиков зависят от драйвера.
Дополнительно:
tc -s qdisc show dev ens192Команда позволяет исследовать состояние дисциплин очередей Linux, включая статистику отброшенных пакетов, если она предоставляется.
Важно: отсутствие ошибок на локальном интерфейсе ещё не доказывает отсутствие потерь на всём маршруте.
Шаг 4. Проверяем сам TCP-трафик
Если предыдущие проверки не позволяют локализовать проблему, используем захват пакетов.
Например:
tcpdump -ni ens192 -s 0 -w /tmp/tcp.pcap 'tcp and host 192.0.2.10'Полученный файл можно исследовать в Wireshark.
Особенно полезны признаки:
— TCP Retransmission;
— TCP Fast Retransmission;
— TCP Duplicate ACK;
— TCP Out-of-Order;
— TCP Spurious Retransmission.
Но и здесь нужна осторожность: Wireshark анализирует доступный ему трафик, а не состояние сети целиком. Неполный захват способен привести к ошибочным выводам.
В сложных случаях значительно полезнее синхронно захватить трафик на отправителе и получателе и сопоставить последовательности TCP-сегментов.
Так можно определить, какие данные покинули отправителя, какие дошли до получателя и какие подтверждения были отправлены обратно.
При захвате необходимо учитывать сетевые offload-механизмы, возможные ограничения производительности и конфиденциальность содержимого трафика.
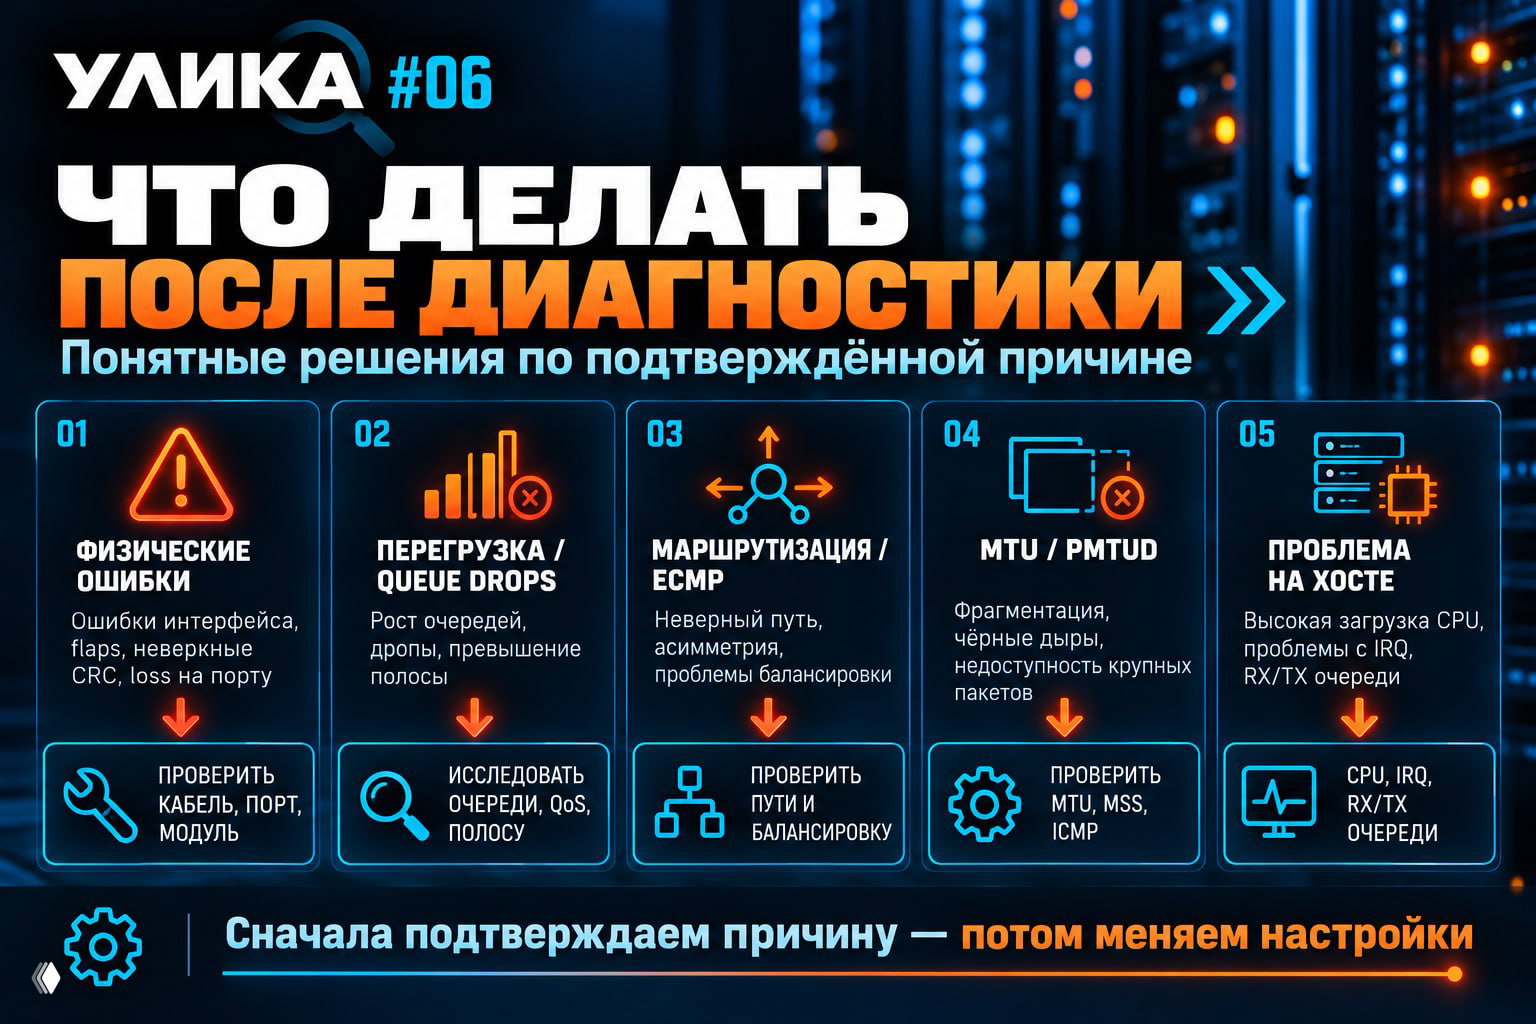
4. ПОНЯТНЫЕ РЕШЕНИЯ
Теперь главное: что именно исправлять?
Сценарий A. Подтверждены ошибки физического соединения
Если одновременно растут ошибки интерфейса, например CRC, и установлена их связь с проблемным соединением:
→ проверить кабельную линию, оптические модули и порты;
→ исследовать параметры линка и физические ошибки;
→ заменить неисправный компонент после локализации проблемы.
Сценарий B. Подтверждена перегрузка
Если retransmissions сопровождаются отбрасыванием пакетов в очередях и насыщением канала:
→ установить, где именно возникает перегрузка;
→ проверить ограничения полосы пропускания и QoS;
→ оценить всплески нагрузки;
→ при необходимости изменить распределение трафика, настройки управления очередями или пропускную способность.
Просто увеличить буферы — не универсальное решение. Это может уменьшить потери, но одновременно увеличить задержки.
Сценарий C. Проблемы связаны с маршрутизацией
Если анализ показывает переупорядочивание или потери на отдельных путях:
→ проверить ECMP и балансировку;
→ исследовать симметрию маршрутов;
→ проверить политики на промежуточных устройствах;
→ сопоставить поведение разных маршрутов.
Сценарий D. Проблема связана с MTU/PMTUD
Если короткие запросы проходят, а крупные передачи зависают или повторяются:
→ проверить MTU на участках маршрута;
→ исследовать работу PMTUD и доставку необходимых ICMP-сообщений;
→ проверить туннели, инкапсуляцию и согласование MSS.
Изменение MTU или MSS должно следовать из диагностики, а не выполняться наугад.
Сценарий E. Потери возникают на Linux-сервере
Если сетевой интерфейс и локальные очереди демонстрируют отбрасывание пакетов при высокой нагрузке:
→ проверить загрузку CPU и обработку сетевых прерываний;
→ исследовать RX/TX-очереди и возможности драйвера;
→ проверить распределение нагрузки по процессорам;
→ корректировать сетевые параметры только после установления ограничивающего ресурса.
5. ПРОВЕРКА РЕЗУЛЬТАТА
После изменений повторяем диагностику при сопоставимой нагрузке.
Оцениваем:
— частоту повторных передач TCP;
— RTT и его колебания;
— ошибки и потери на интерфейсах;
— пропускную способность проблемных соединений;
— время ответа приложения и количество тайм-аутов.
Цель — не добиться абсолютного нуля в TcpRetransSegs, а устранить подтверждённую проблему и убедиться, что показатели действительно улучшились.
ГЛАВНЫЙ ВЫВОД
Рост TCP retransmissions — важный диагностический сигнал.
Но он сам по себе не отвечает на вопрос, где находится неисправность: на отправителе, получателе или в сети между ними.
Правильная последовательность:
Retransmissions ↑
↓
Определить проблемные соединения
↓
Проверить RTT, ошибки и очереди
↓
Локализовать потери или задержки
↓
Подтвердить причину
↓
Исправить и проверить результат
Повторная передача — следствие работы TCP-механизма восстановления, а не готовый диагноз сетевой инфраструктуры
.
#УликиИнфры #Linux #TCP #Network #Troubleshooting
Дискуссия